Idioma: Português (BR)
IR-09 · iac
Pushkar Kumar 11 min de leitura
Terraform forces replacement: o que é -/+ e como evitar
Terraform forces replacement quando um atributo não muda in-place: o que -/+ significa, como achar a causa com show -json e jq, e como impedir isso.
- terraform
- ci-cd
- devops
Nesta página
- O que significa “terraform forces replacement”?
- Por que algumas substituições não têm a linha ”# forces replacement”?
- Como encontrar o atributo que forçou a substituição?
- Qual é a sua causa?
- O valor mudou na sua config
- A substituição veio de fora do diff
- Como evitar uma substituição sem quebrar outra coisa?
- ignore_changes é a correção que não corrige?
- Como fazer o CI falhar quando um plan substitui um banco de dados?
- O que conferir antes de aprovar um plan -/+?
Você pediu uma mudança pequena: ativar a criptografia de um banco de dados. O pull request tem três linhas. Aí o plan volta, e um recurso nele (resumido aqui) deveria fazer você parar na hora:
  # module.data.aws_db_instance.primary must be replaced
-/+ resource "aws_db_instance" "primary" {
      ~ storage_encrypted                     = false -> true # forces replacement
        # (35 unchanged attributes hidden)
    }

Plan: 1 to add, 1 to change, 1 to destroy.
Quando o Terraform força uma substituição, o “1 to destroy” é o seu banco de dados de produção. O plan não está errado. Ele está dizendo que a mudança não pode ser feita in-place e que, se você aprovar, o objeto antigo é apagado primeiro.
TL;DR
-/+significa destruir e depois criar.+/-significa criar e depois destruir, e só aparece quandocreate_before_destroyestá em vigor.# forces replacementaponta o atributo culpado, mas substituições vindas de-replace, taint ereplace_triggered_bynunca o imprimem.- A verificação que não deixa nenhuma escapar:
terraform show -json tfplan | jqsobre.change.actions,.action_reasone.change.replace_paths.- Corrija a causa (revert,
moved,name_prefix), proteja os data stores comprevent_destroye faça o CI falhar em qualquer plan que apague um deles.
O que significa “terraform forces replacement”?
Todo recurso gerenciado tem argumentos que o provider consegue alterar por uma API de update, e argumentos que não consegue. No provider da AWS, storage_encrypted em aws_db_instance é do segundo tipo: o schema o marca como ForceNew. O mesmo vale para kms_key_id, availability_zone, db_name e username. Já engine_version não é, e é por isso que subir a versão atualiza in-place.
Quando qualquer atributo desses muda, o Terraform planeja uma substituição. A legenda do plan descreve as duas ordens:
-/+ destroy and then create replacement
+/- create replacement and then destroy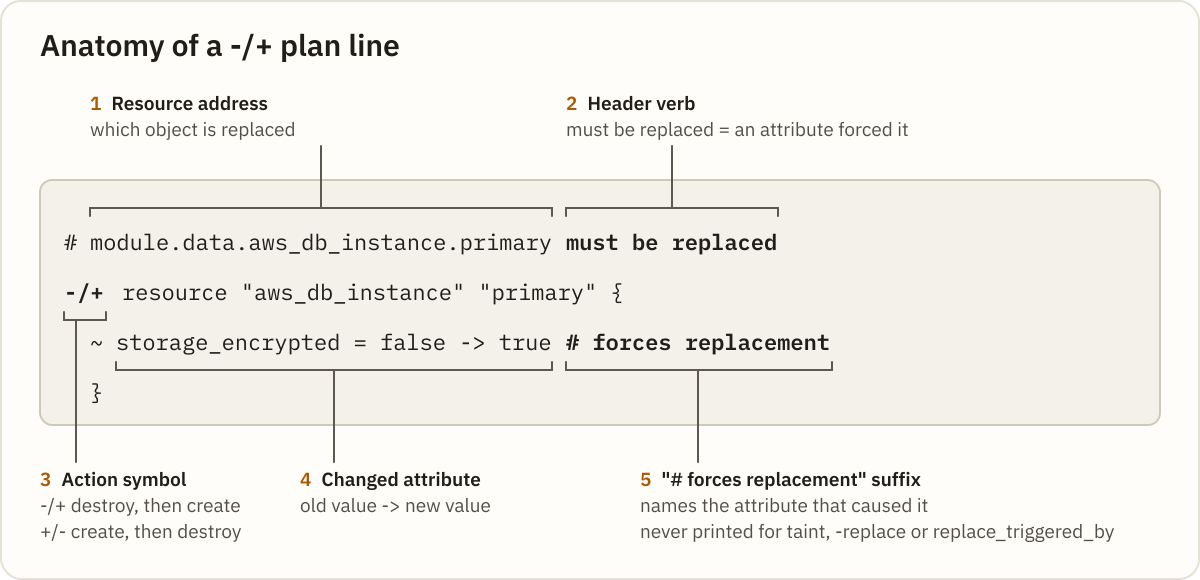
Destruir e depois criar é o padrão. O Terraform só passa para +/- quando create_before_destroy se aplica ao recurso. A linha de cabeçalho acima do recurso importa tanto quanto o símbolo. must be replaced significa que um atributo forçou a substituição. Os outros verbos significam que foi outra coisa, e essa é a próxima pergunta.
Por que algumas substituições não têm a linha ”# forces replacement”?
Fazer grep por forces replacement no plan parece uma verificação completa. Não é. O Terraform só imprime esse sufixo nos atributos que o provider reportou como exigindo substituição. Três tipos de substituição não têm atributo nenhum, então o verbo do cabeçalho é a única pista:
  # aws_instance.app is tainted, so must be replaced
  # aws_instance.app will be replaced, as requested
  # aws_instance.app will be replaced due to changes in replace_triggered_by
O primeiro vem de terraform taint (hoje descontinuado em favor de -replace), o segundo de terraform apply -replace=ADDRESS e o terceiro de uma regra de lifecycle replace_triggered_by.
Há uma quarta armadilha. Se um provider marca como exigindo substituição um atributo que não mudou, o Terraform pode escondê-lo dentro de (N unchanged attributes hidden). Isso foi reportado como hashicorp/terraform#36097 e fechado como comportamento esperado. O plan diz must be replaced e não mostra culpado nenhum.
Como encontrar o atributo que forçou a substituição?
Pare de ler o plan para humanos e leia o plan para máquinas. Toda substituição traz actions iguais a ["delete","create"] ou ["create","delete"] no formato JSON do plan, além de um action_reason e, quando um atributo foi o responsável, replace_paths.
terraform plan -out=tfplan
terraform show -json tfplan > plan.json
jq -c '.resource_changes[]
  | select(.change.actions | index("delete"))
  | {address, actions: .change.actions, reason: .action_reason, paths: .change.replace_paths}' plan.json
Isso lista toda destruição ou substituição. Num plan com três substituições, sai uma linha para cada:
{"address":"module.data.aws_db_instance.primary","actions":["delete","create"],"reason":"replace_because_cannot_update","paths":[["storage_encrypted"]]}
{"address":"aws_lb_target_group.web","actions":["create","delete"],"reason":"replace_because_cannot_update","paths":[["port"]]}
{"address":"aws_instance.app","actions":["delete","create"],"reason":"replace_by_triggers","paths":null}
replace_paths é omitido quando nenhum atributo causou a substituição. Um null ali junto com replace_by_triggers ou replace_because_tainted significa que você deve olhar as regras de lifecycle ou o state, não o diff. A HashiCorp chama esses motivos de dicas de exibição que podem mudar, então trate um que você não reconhece como não especificado. Você pode testar o filtro no seu próprio plan no jq playground.
Se você prefere não escrever jq no meio de um incidente, cole o plan no Terraform Plan Summarizer. No exemplo completo RDS replace (o plan acima mais um update in-place de parameter group), ele informa plan text · 2 actions · 1 high risk · counts reconcile, e o relatório em Markdown lista:
- `module.data.aws_db_instance.primary` — destroy then create — forces replacement: storage_encryptedO limite dele, dito com honestidade: a partir do texto do plan, ele sinaliza substituições por taint, -replace e trigger, mas só consegue nomear atributos que o Terraform imprimiu com # forces replacement. Para um culpado escondido ou para o motivo exato, cole a saída de terraform show -json tfplan.
Qual é a sua causa?
Depois que você sabe o motivo e o path, a causa costuma ser uma de seis, mais ou menos na ordem de quantas vezes elas pegam alguém.
| O que você vê | Causa provável | Primeiro passo |
|---|---|---|
false -> true # forces replacement numa linha que você editou | Atributo imutável alterado | Reverter, ou planejar uma migração |
-> (known after apply) # forces replacement | Valor upstream desconhecido | Rastrear a referência |
| Substituição sem mudança na config | Drift ou normalização | terraform plan -refresh-only |
| O plan mudou quando o lock file mudou | Upgrade do provider | Ler o CHANGELOG do provider |
Cabeçalho tainted / as requested | Taint ou -replace | Conferir o state |
Cabeçalho replace_triggered_by | Trigger de lifecycle | Conferir o escopo do trigger |
O valor mudou na sua config
1. Você editou um atributo imutável. O sinal é um valor concreto old -> new com o sufixo. A correção é reverter, ou aceitar a substituição como uma migração planejada (no caso da criptografia do RDS, isso significa um snapshot e um restore que você controla). Confirme com um plan novo que o recurso aparece como ~ update in-place ou nem aparece.
2. O valor é (known after apply). O sinal é <before> -> (known after apply) # forces replacement. Em providers construídos sobre o plugin SDKv2, o que cobre a maior parte do hashicorp/aws, um argumento ForceNew cujo novo valor é desconhecido é marcado como exigindo substituição mesmo que o valor final acabe sendo idêntico.
O upstream costuma ser outro recurso sendo substituído, ou um depends_on que, como alerta a documentação de depends_on, torna mais valores desconhecidos. Corrija referenciando um atributo estável, ou usando referências de expressão em vez de depends_on. Confirme que a linha passa a mostrar um valor concreto.
A substituição veio de fora do diff
3. Drift ou normalização. O sinal é uma substituição que ninguém pediu, em que a API devolveu um valor num formato diferente do que a config escreveu. Rode terraform plan -refresh-only para ver o que mudou fora do Terraform e depois ajuste a config para bater com o que a API devolve.
4. Um upgrade do provider. O sinal é que o plan mudou no mesmo dia em que o lock file mudou. Leia o CHANGELOG e o guia de upgrade do provider para aquele tipo de recurso antes de presumir que a culpa é da sua config.
5. Taint ou -replace. O sinal é o verbo do cabeçalho e replace_because_tainted ou replace_by_request. Se ninguém fez isso de propósito, remova o taint:
terraform untaint ADDRESS6. replace_triggered_by. Disponível desde o Terraform v1.2, ele substitui um recurso quando um recurso gerenciado referenciado muda. Só recursos gerenciados podem ser referenciados, então uma variável simples precisa passar por terraform_data (v1.4+). Verifique se o trigger é mais amplo do que deveria.
Como evitar uma substituição sem quebrar outra coisa?
Quando a substituição é real mas o problema é a ordem, create_before_destroy transforma -/+ em +/-. A documentação diz que ele é opt-in “because many remote object types have unique name requirements”. Um target group com name fixo mostra o porquê: os nomes precisam ser únicos por região e por conta, então, enquanto o antigo existe, a API do ELBv2 rejeita a criação com DuplicateTargetGroupName.
Troque name por name_prefix (no máximo 6 caracteres para um target group) para que cada substituição ganhe um sufixo único:
resource "aws_lb_target_group" "web" {
  name_prefix = "web-"
  port        = 9090
  protocol    = "HTTP"
  vpc_id      = var.vpc_id

  lifecycle {
    create_before_destroy = true
  }
}
Atenção: o Terraform propaga
create_before_destroypara os recursos dos quais um recurso comcreate_before_destroydepende, então um+/-pode aparecer num recurso cujo próprio bloco nunca o definiu.
Se a substituição veio de uma refatoração, como passar de count para for_each, nada no objeto remoto mudou. Use um bloco moved (Terraform v1.1+) e o plan mostra has moved to em vez de destroy e create:
moved {
  from = aws_instance.c[0]
  to   = aws_instance.c["small"]
}
Para qualquer coisa que guarde dados, adicione uma proteção. prevent_destroy rejeita qualquer plan que destruiria o objeto, inclusive uma substituição forçada (contexto de arquivo e linha omitido):
Error: Instance cannot be destroyed

Resource module.data.aws_db_instance.primary has lifecycle.prevent_destroy set, but the plan calls for this resource to be destroyed. To avoid this error and continue with the plan, either disable lifecycle.prevent_destroy or reduce the scope of the plan using the -target option.
Importante:
prevent_destroynão impede a destruição se alguém apagar o próprio bloco do recurso. Ele também bloqueiaterraform destroy, e os argumentos de lifecycle só aceitam valores literais.
ignore_changes é a correção que não corrige?
ignore_changes é a resposta mais comum nos fóruns, e de fato faz o -/+ sumir. A documentação de lifecycle diz que os argumentos ignorados são considerados ao planejar uma criação, mas ignorados ao planejar um update.
Esse é o problema. Ignorar um atributo ForceNew suprime a substituição e também todo diff futuro nele. Se alguém depois mudar esse atributo fora do Terraform, o plan nunca mais vai mencioná-lo. Sua config diz uma coisa, o objeto real diz outra, e nada reporta a diferença. Com ignore_changes = all, esse silêncio cobre o recurso inteiro.
Use-o para atributos que outro sistema legitimamente controla, como uma tag escrita por um scheduler. Não use para calar um plan assustador. Se o atributo é seu, as opções honestas são reverter a mudança ou substituir de propósito.
Como fazer o CI falhar quando um plan substitui um banco de dados?
A revisão humana deixa passar um -/+ num plan longo. Um pipeline, não. Este filtro sai com código diferente de zero sempre que o plan apaga um data store, seja por destruição ou por substituição:
terraform show -json tfplan > plan.json
jq -e '[.resource_changes[]
  | select((.change.actions | index("delete"))
      and (.type | test("^aws_(db_instance|rds_cluster|dynamodb_table|s3_bucket|efs_file_system)$")))]
  | length == 0' plan.json
No plan acima, ele imprime false e sai com 1. Num plan limpo, imprime true e sai com 0. Rode-o como etapa obrigatória antes do apply e faça com que ignorá-lo seja uma ação deliberada e revisada.
Dica: mantenha a lista de tipos junto do pipeline e amplie-a com tudo o que guarda state na sua conta. O guia de AWS para engenheiros DevOps cobre backups do RDS e snapshots manuais, a sua cópia de segurança antes de qualquer substituição planejada.
A mesma verificação se encaixa em qualquer runner. Se o seu pipeline vive no GitHub Actions, combine-a com as verificações de configurações de segurança incorretas no GitHub Actions. No GitLab, validar o .gitlab-ci.yml evita que o job que a executa quebre em silêncio.
O que conferir antes de aprovar um plan -/+?
- Leia o verbo do cabeçalho, não só o símbolo:
must be replaced,is tainted,as requestedereplace_triggered_byapontam para causas diferentes. - Rode
terraform show -json tfplane liste todo recurso cujasactionsincluamdelete, comaction_reasonereplace_paths. - Para cada
replace_paths, confirme que o atributo é realmente imutável para aquele tipo de recurso. - Para
(known after apply), rastreie a referência até o recurso que a torna desconhecida. - Para uma substituição sem mudança na config, rode
terraform plan -refresh-onlye confira o changelog do provider. - Para uma refatoração, adicione um bloco
movede rode o plan de novo até a destruição sumir. - Para
create_before_destroy, confirme que os nomes podem coexistir, ou troque paraname_prefix. - Confirme que todo data store tem
prevent_destroye que o CI roda a verificação com jq.
Da próxima vez que um plan disser -/+, cole-o no Terraform Plan Summarizer antes que alguém clique em aprovar.
Qual foi a substituição que chegou mais longe na sua revisão antes de alguém notar o -/+?
Posts relacionados
-

8 min de leitura
Comando chown no Linux: mudar dono e grupo de arquivos
O comando chown no Linux explicado: sintaxe user:group, chown -R e links simbólicos, --reference, chgrp, chmod vs chown e como corrigir permissões de volumes Docker com IDs numéricos.
-

11 min de leitura
Comando chmod no Linux: sintaxe, exemplos e erros comuns
O comando chmod no Linux explicado: modos octal e simbólico, chmod +x, chmod -R e suas armadilhas, setuid, setgid e sticky bit, umask e como resolver Permission denied.
-
8 min de leitura
Como ler a notação CIDR, com exemplos do mundo real
Como ler a notação CIDR: o número depois da barra, uma tabela de prefixo para máscara de /8 a /32 e exemplos reais de VPCs, firewalls e Kubernetes.