Idioma: Español
IR-09 · iac
Pushkar Kumar 11 min de lectura
Terraform forces replacement: qué es -/+ y cómo evitarlo
Terraform fuerza un reemplazo cuando un atributo no puede cambiar in situ: qué significa -/+, cómo hallar la causa con show -json y jq, y cómo evitarlo.
- terraform
- ci-cd
- devops
En esta página
- ¿Qué significa “terraform forces replacement”?
- ¿Por qué algunos reemplazos no muestran la línea ”# forces replacement”?
- ¿Cómo encuentras el atributo que forzó el reemplazo?
- ¿Cuál es tu causa?
- El valor cambió en tu configuración
- El reemplazo vino de fuera del diff
- ¿Cómo evitas un reemplazo sin romper otra cosa?
- ¿Es ignore_changes la solución que no soluciona nada?
- ¿Cómo haces que CI falle cuando un plan reemplaza una base de datos?
- ¿Qué deberías revisar antes de aprobar un plan con -/+?
Pediste un cambio pequeño: activar el cifrado de una base de datos. La pull request son tres líneas. Luego llega el plan, y uno de sus recursos (recortado aquí) debería frenarte en seco:
  # module.data.aws_db_instance.primary must be replaced
-/+ resource "aws_db_instance" "primary" {
      ~ storage_encrypted                     = false -> true # forces replacement
        # (35 unchanged attributes hidden)
    }

Plan: 1 to add, 1 to change, 1 to destroy.
Cuando Terraform fuerza un reemplazo, ese “1 to destroy” es tu base de datos de producción. El plan no se equivoca. Te está diciendo que el cambio no se puede aplicar in situ y que, si lo apruebas, primero se borra el objeto antiguo.
TL;DR
-/+significa destruir y luego crear.+/-significa crear y luego destruir, y solo aparece cuandocreate_before_destroyestá en vigor.# forces replacementseñala al atributo culpable, pero los reemplazos que vienen de-replace, de un taint o dereplace_triggered_bynunca lo imprimen.- La comprobación que no se salta ninguno:
terraform show -json tfplan | jqsobre.change.actions,.action_reasony.change.replace_paths.- Corrige la causa (revertir,
moved,name_prefix), protege los almacenes de datos conprevent_destroyy haz que CI falle ante cualquier plan que borre uno.
¿Qué significa “terraform forces replacement”?
Todo recurso gestionado tiene argumentos que el provider puede cambiar mediante una API de actualización y argumentos que no. En el provider de AWS, storage_encrypted de aws_db_instance es de los segundos: el schema lo marca como ForceNew. Lo mismo ocurre con kms_key_id, availability_zone, db_name y username. engine_version no lo es, y por eso subir de versión se actualiza in situ.
Cuando cambia cualquiera de esos atributos, Terraform planifica un reemplazo. La leyenda del plan describe los dos órdenes posibles:
-/+ destroy and then create replacement
+/- create replacement and then destroy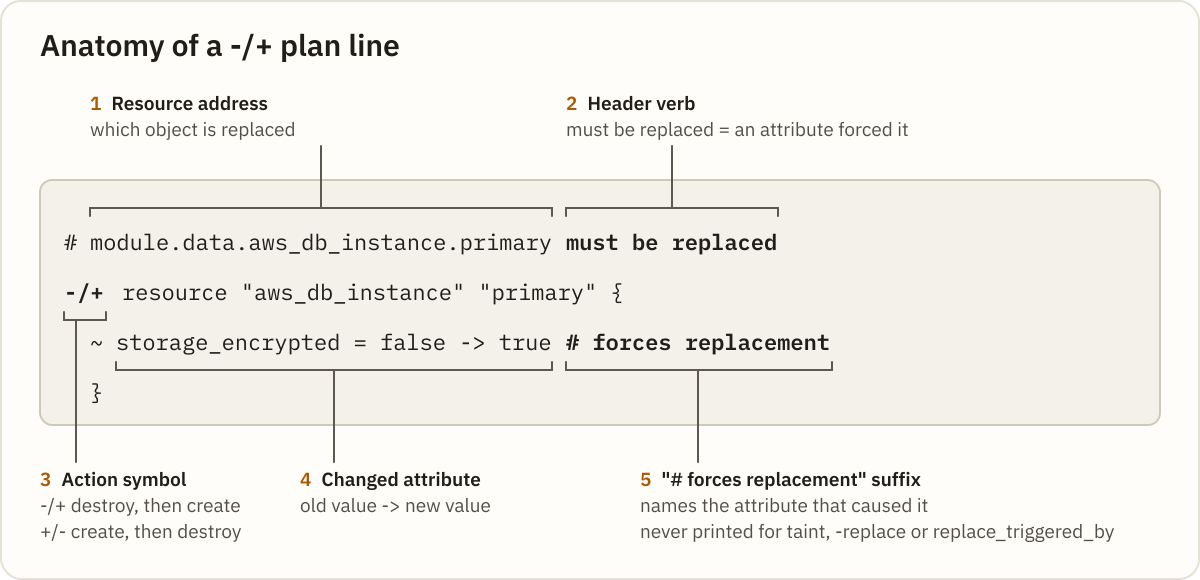
Destruir y luego crear es el comportamiento por defecto. Terraform solo pasa a +/- cuando create_before_destroy se aplica al recurso. La línea de cabecera sobre el recurso importa tanto como el símbolo. must be replaced significa que lo forzó un atributo. Los demás verbos significan que fue otra cosa, y esa es la siguiente pregunta.
¿Por qué algunos reemplazos no muestran la línea ”# forces replacement”?
Buscar forces replacement con grep en el plan parece una comprobación completa. No lo es. Terraform solo imprime ese sufijo en los atributos que el provider notificó como causantes del reemplazo. Hay tres tipos de reemplazo que no tienen ningún atributo así, de modo que el verbo de la cabecera es la única pista:
  # aws_instance.app is tainted, so must be replaced
  # aws_instance.app will be replaced, as requested
  # aws_instance.app will be replaced due to changes in replace_triggered_by
El primero viene de terraform taint (ahora obsoleto en favor de -replace), el segundo de terraform apply -replace=ADDRESS y el tercero de una regla de lifecycle replace_triggered_by.
Hay una cuarta trampa. Si un provider marca como causante del reemplazo un atributo que no cambió, Terraform puede englobarlo en (N unchanged attributes hidden). Se reportó como hashicorp/terraform#36097 y se cerró como comportamiento esperado. El plan dice must be replaced y no muestra ningún culpable.
¿Cómo encuentras el atributo que forzó el reemplazo?
Deja de leer el plan para humanos y lee el de máquina. Todo reemplazo lleva actions con ["delete","create"] o ["create","delete"] en el formato JSON del plan, además de un action_reason y, cuando el responsable fue un atributo, replace_paths.
terraform plan -out=tfplan
terraform show -json tfplan > plan.json
jq -c '.resource_changes[]
  | select(.change.actions | index("delete"))
  | {address, actions: .change.actions, reason: .action_reason, paths: .change.replace_paths}' plan.json
Lista cada destrucción o reemplazo. En un plan con tres reemplazos imprime una línea por cada uno:
{"address":"module.data.aws_db_instance.primary","actions":["delete","create"],"reason":"replace_because_cannot_update","paths":[["storage_encrypted"]]}
{"address":"aws_lb_target_group.web","actions":["create","delete"],"reason":"replace_because_cannot_update","paths":[["port"]]}
{"address":"aws_instance.app","actions":["delete","create"],"reason":"replace_by_triggers","paths":null}
replace_paths se omite cuando ningún atributo causó el reemplazo. Un null ahí junto a replace_by_triggers o replace_because_tainted significa que hay que mirar las reglas de lifecycle o el state, no el diff. HashiCorp describe estos motivos como pistas de presentación que pueden cambiar, así que trata uno desconocido como no especificado. Puedes probar el filtro con tu propio plan en el jq playground.
Si prefieres no escribir jq en mitad de un incidente, pega el plan en el Terraform Plan Summarizer. Con su ejemplo completo RDS replace (el plan de arriba más una actualización in situ de un parameter group) informa plan text · 2 actions · 1 high risk · counts reconcile, y su informe en Markdown incluye:
- `module.data.aws_db_instance.primary` — destroy then create — forces replacement: storage_encryptedSu límite, dicho con honestidad: a partir del texto del plan señala los reemplazos por taint, por -replace y por triggers, pero solo puede nombrar los atributos que Terraform imprimió con # forces replacement. Para un culpable oculto o el motivo exacto, pega en su lugar la salida de terraform show -json tfplan.
¿Cuál es tu causa?
Una vez que conoces el motivo y la ruta, la causa suele ser una de estas seis, ordenadas más o menos por la frecuencia con la que muerden.
| Lo que ves | Causa probable | Primer paso |
|---|---|---|
false -> true # forces replacement en una línea que editaste | Cambió un atributo inmutable | Revertir, o planificar una migración |
-> (known after apply) # forces replacement | Valor desconocido aguas arriba | Rastrear la referencia |
| Reemplazo sin cambios en la configuración | Drift o normalización | terraform plan -refresh-only |
| El plan cambió cuando cambió el lock file | Actualización del provider | Leer el CHANGELOG del provider |
Cabecera tainted / as requested | Taint o -replace | Revisar el state |
Cabecera replace_triggered_by | Trigger de lifecycle | Revisar el alcance del trigger |
El valor cambió en tu configuración
1. Editaste un atributo inmutable. La señal es un valor concreto old -> new con el sufijo. La solución es revertir, o aceptar el reemplazo como una migración planificada (para el cifrado de RDS, eso significa un snapshot y una restauración que controles tú). Comprueba con un plan nuevo que el recurso muestra ~ update in-place o nada.
2. El valor es (known after apply). La señal es <before> -> (known after apply) # forces replacement. En los providers construidos sobre plugin SDKv2, que abarca la mayor parte de hashicorp/aws, un argumento ForceNew cuyo nuevo valor es desconocido se marca como causante de reemplazo aunque el valor final resulte idéntico.
El origen suele ser otro recurso que se está reemplazando, o un depends_on, que según advierte la documentación de depends_on vuelve desconocidos más valores. Arréglalo referenciando un atributo estable, o usando referencias en expresiones en lugar de depends_on. Comprueba que la línea muestra un valor concreto.
El reemplazo vino de fuera del diff
3. Drift o normalización. La señal es un reemplazo que nadie pidió, en el que la API devolvió un valor con una forma distinta a la que escribió la configuración. Ejecuta terraform plan -refresh-only para ver qué cambió fuera de Terraform y luego haz que la configuración coincida con lo que devuelve la API.
4. Una actualización del provider. La señal es que el plan cambió el mismo día que el lock file. Lee el CHANGELOG del provider y su guía de actualización para ese tipo de recurso antes de dar por hecho que la culpa es de tu configuración.
5. Taint o -replace. La señal es el verbo de la cabecera y replace_because_tainted o replace_by_request. Si nadie lo pretendía, quita el taint:
terraform untaint ADDRESS6. replace_triggered_by. Disponible desde Terraform v1.2, reemplaza un recurso cuando cambia un recurso gestionado al que hace referencia. Solo se pueden referenciar recursos gestionados, así que una variable simple tiene que pasar por terraform_data (v1.4+). Comprueba si el trigger es más amplio de lo que pretendías.
¿Cómo evitas un reemplazo sin romper otra cosa?
Cuando el reemplazo es real pero el problema es el orden, create_before_destroy convierte -/+ en +/-. La documentación explica que es opcional “because many remote object types have unique name requirements”. Un target group con un name fijo muestra por qué: los nombres deben ser únicos por región y por cuenta, así que mientras exista el antiguo, la API de ELBv2 rechaza la creación con DuplicateTargetGroupName.
Cambia name por name_prefix (como máximo 6 caracteres en un target group) para que cada reemplazo reciba un sufijo único:
resource "aws_lb_target_group" "web" {
  name_prefix = "web-"
  port        = 9090
  protocol    = "HTTP"
  vpc_id      = var.vpc_id

  lifecycle {
    create_before_destroy = true
  }
}
Cuidado: Terraform propaga
create_before_destroya los recursos de los que depende un recurso concreate_before_destroy, así que puede aparecer un+/-en un recurso cuyo propio bloque nunca lo activó.
Si el reemplazo vino de una refactorización, como pasar de count a for_each, no cambió nada del objeto remoto. Usa un bloque moved (Terraform v1.1+) y el plan mostrará has moved to en lugar de destruir y crear:
moved {
  from = aws_instance.c[0]
  to   = aws_instance.c["small"]
}
Para todo lo que guarde datos, añade una protección. prevent_destroy rechaza cualquier plan que destruya el objeto, incluido un reemplazo forzado (contexto de archivo y línea recortado):
Error: Instance cannot be destroyed

Resource module.data.aws_db_instance.primary has lifecycle.prevent_destroy set, but the plan calls for this resource to be destroyed. To avoid this error and continue with the plan, either disable lifecycle.prevent_destroy or reduce the scope of the plan using the -target option.
Importante:
prevent_destroyno impide la destrucción si alguien borra el propio bloque del recurso. También bloqueaterraform destroy, y los argumentos de lifecycle solo aceptan valores literales.
¿Es ignore_changes la solución que no soluciona nada?
ignore_changes es la respuesta más habitual en los foros, y es cierto que hace desaparecer el -/+. La documentación de lifecycle dice que los argumentos ignorados se tienen en cuenta al planificar una creación, pero se ignoran al planificar una actualización.
Ahí está el problema. Ignorar un atributo ForceNew suprime el reemplazo y también cualquier diff futuro sobre él. Si más adelante alguien cambia ese atributo fuera de Terraform, el plan no vuelve a mencionarlo nunca. Tu configuración dice una cosa, el objeto real dice otra y nada informa de la diferencia. Con ignore_changes = all, ese silencio cubre el recurso entero.
Úsalo para atributos que otro sistema gestiona legítimamente, como una etiqueta que escribe un scheduler. No lo uses para acallar un plan que da miedo. Si el atributo es tuyo, las opciones honestas son revertir el cambio o reemplazar a propósito.
¿Cómo haces que CI falle cuando un plan reemplaza una base de datos?
La revisión humana se salta un -/+ en un plan largo. Un pipeline, no. Este filtro sale con un código distinto de cero siempre que el plan borre un almacén de datos, ya sea por destrucción o por reemplazo:
terraform show -json tfplan > plan.json
jq -e '[.resource_changes[]
  | select((.change.actions | index("delete"))
      and (.type | test("^aws_(db_instance|rds_cluster|dynamodb_table|s3_bucket|efs_file_system)$")))]
  | length == 0' plan.json
Con el plan de arriba imprime false y sale con 1. Con un plan limpio imprime true y sale con 0. Ejecútalo como paso obligatorio antes de apply, y haz que saltárselo sea una acción deliberada y revisada.
Consejo: Mantén la lista de tipos junto al pipeline y amplíala con todo lo que guarde estado en tu cuenta. La guía de AWS para ingenieros DevOps cubre los backups de RDS y los snapshots manuales, tu copia de seguridad antes de cualquier reemplazo planificado.
La misma comprobación encaja en cualquier runner. Si tu pipeline vive en GitHub Actions, combínala con las comprobaciones de errores de seguridad en GitHub Actions. En GitLab, validar .gitlab-ci.yml evita que el job que la ejecuta se rompa en silencio.
¿Qué deberías revisar antes de aprobar un plan con -/+?
- Lee el verbo de la cabecera, no solo el símbolo:
must be replaced,is tainted,as requestedyreplace_triggered_byapuntan a causas distintas. - Ejecuta
terraform show -json tfplany lista todos los recursos cuyasactionsincluyandelete, conaction_reasonyreplace_paths. - Para cada
replace_paths, confirma que el atributo es realmente inmutable para ese tipo de recurso. - Para
(known after apply), rastrea la referencia hasta el recurso que la vuelve desconocida. - Para un reemplazo sin cambios en la configuración, ejecuta
terraform plan -refresh-onlyy revisa el changelog del provider. - Para una refactorización, añade un bloque
movedy vuelve a planificar hasta que desaparezca la destrucción. - Para
create_before_destroy, confirma que los nombres pueden coexistir, o cambia aname_prefix. - Confirma que todos los almacenes de datos llevan
prevent_destroyy que CI ejecuta la comprobación con jq.
La próxima vez que un plan diga -/+, pégalo en el Terraform Plan Summarizer antes de que nadie pulse aprobar.
¿Cuál es el reemplazo que más lejos llegó en tu revisión antes de que alguien se diera cuenta del -/+?
Publicaciones relacionadas
-

8 min de lectura
Comando chown en Linux: cambiar propietario y grupo de archivos
El comando chown en Linux explicado: sintaxis user:group, chown -R y enlaces simbólicos, --reference, chgrp, chmod vs chown y cómo arreglar permisos de volúmenes Docker con IDs numéricos.
-

11 min de lectura
Comando chmod en Linux: sintaxis, ejemplos y errores comunes
El comando chmod en Linux explicado: modos octal y simbólico, chmod +x, chmod -R y sus trampas, setuid, setgid y sticky bit, umask y cómo resolver Permission denied.
-
9 min de lectura
Cómo leer la notación CIDR, con ejemplos reales
Cómo leer la notación CIDR: qué significa el número tras la barra, una tabla de prefijo a máscara de /8 a /32 y ejemplos reales de VPC, firewalls y Kubernetes.