Sprache: Deutsch
IR-09 · iac
Pushkar Kumar 11 Min. Lesezeit
Terraform forces replacement: -/+ verstehen und beheben
Terraform erzwingt ein Replacement, wenn ein Attribut nicht in place änderbar ist: was -/+ heißt, die Ursache per show -json und jq finden und es verhindern.
- terraform
- ci-cd
- devops
Auf dieser Seite
- Was bedeutet „terraform forces replacement“?
- Warum fehlt bei manchen Replacements die Zeile „# forces replacement“?
- Wie findest du das Attribut, das das Replacement erzwungen hat?
- Welche Ursache ist deine?
- Der Wert hat sich in deiner Config geändert
- Das Replacement kam von außerhalb des Diffs
- Wie verhinderst du ein Replacement, ohne etwas anderes kaputtzumachen?
- Ist ignore_changes die Lösung, die keine ist?
- Wie lässt du CI scheitern, wenn ein Plan eine Datenbank ersetzt?
- Was solltest du prüfen, bevor du einen -/+-Plan freigibst?
Du wolltest nur eine kleine Änderung: Verschlüsselung für eine Datenbank einschalten. Der Pull Request hat drei Zeilen. Dann kommt der Plan zurück, und eine Ressource darin (hier gekürzt) sollte dich sofort stoppen:
  # module.data.aws_db_instance.primary must be replaced
-/+ resource "aws_db_instance" "primary" {
      ~ storage_encrypted                     = false -> true # forces replacement
        # (35 unchanged attributes hidden)
    }

Plan: 1 to add, 1 to change, 1 to destroy.
Wenn Terraform ein Replacement erzwingt, ist „1 to destroy“ deine Produktionsdatenbank. Der Plan ist nicht falsch. Er sagt dir, dass sich die Änderung nicht in place umsetzen lässt – und dass ein Approve zuerst das alte Objekt löscht.
TL;DR
-/+heißt: erst löschen, dann anlegen.+/-heißt: erst anlegen, dann löschen – und taucht nur auf, wenncreate_before_destroygreift.# forces replacementmarkiert das schuldige Attribut, aber Replacements durch-replace, Taint undreplace_triggered_bygeben es nie aus.- Die Prüfung, der keines entgeht:
terraform show -json tfplan | jqüber.change.actions,.action_reasonund.change.replace_paths.- Behebe die Ursache (Revert,
moved,name_prefix), schütze Datenspeicher mitprevent_destroyund lass CI bei jedem Plan scheitern, der einen davon löscht.
Was bedeutet „terraform forces replacement“?
Jede verwaltete Ressource hat Argumente, die der Provider über eine Update-API ändern kann, und solche, bei denen das nicht geht. Im AWS-Provider gehört storage_encrypted an aws_db_instance zur zweiten Sorte: Das Schema markiert es als ForceNew. Dasselbe gilt für kms_key_id, availability_zone, db_name und username. engine_version gehört nicht dazu – deshalb wird ein Versionssprung in place aktualisiert.
Ändert sich eines dieser Attribute, plant Terraform ein Replacement. Die Legende des Plans nennt die beiden Reihenfolgen:
-/+ destroy and then create replacement
+/- create replacement and then destroy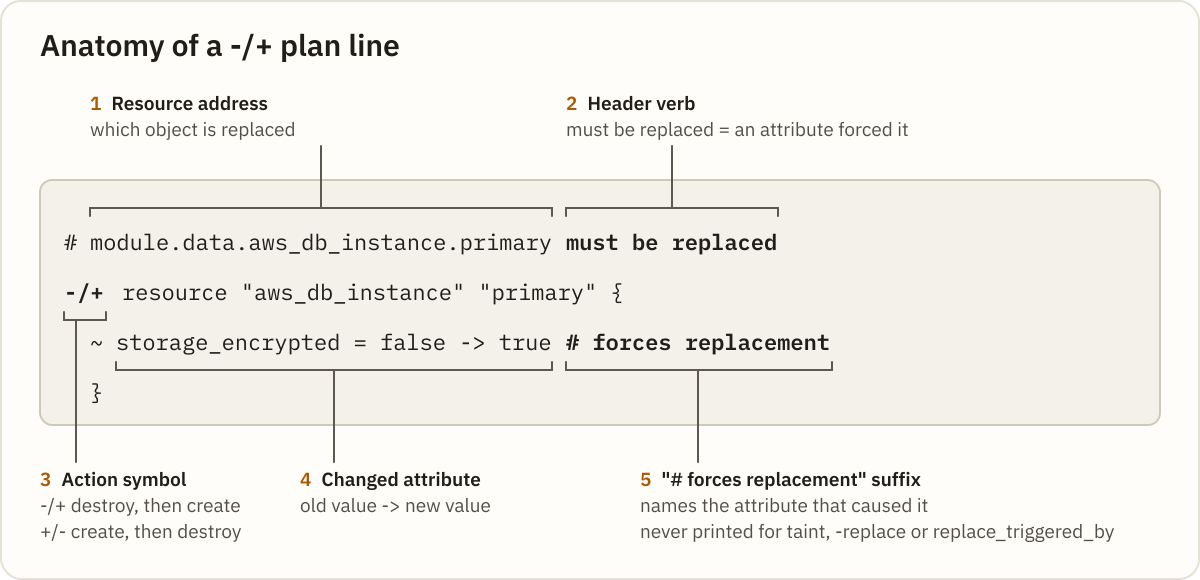
Erst löschen, dann anlegen ist der Standard. Terraform wechselt nur dann zu +/-, wenn create_before_destroy für die Ressource gilt. Die Header-Zeile über der Ressource ist genauso wichtig wie das Symbol. must be replaced bedeutet, dass ein Attribut das Replacement erzwungen hat. Die anderen Verben bedeuten, dass etwas anderes dahintersteckt – und das ist die nächste Frage.
Warum fehlt bei manchen Replacements die Zeile „# forces replacement“?
Den Plan nach forces replacement zu greppen, fühlt sich wie eine vollständige Prüfung an. Ist es aber nicht. Terraform hängt diesen Zusatz nur an Attribute, die der Provider als replacement-pflichtig gemeldet hat. Drei Arten von Replacement haben kein solches Attribut, dort ist das Verb im Header der einzige Hinweis:
  # aws_instance.app is tainted, so must be replaced
  # aws_instance.app will be replaced, as requested
  # aws_instance.app will be replaced due to changes in replace_triggered_by
Das erste stammt von terraform taint (inzwischen zugunsten von -replace als veraltet markiert), das zweite von terraform apply -replace=ADDRESS, das dritte von einer replace_triggered_by-Lifecycle-Regel.
Es gibt noch eine vierte Falle. Markiert ein Provider ein Attribut, das sich nicht geändert hat, als replacement-pflichtig, kann Terraform es in (N unchanged attributes hidden) verschwinden lassen. Das wurde als hashicorp/terraform#36097 gemeldet und als „works as designed“ geschlossen. Der Plan sagt must be replaced und zeigt überhaupt keinen Schuldigen.
Wie findest du das Attribut, das das Replacement erzwungen hat?
Hör auf, den menschenlesbaren Plan zu lesen, und lies den maschinenlesbaren. Jedes Replacement trägt im JSON-Plan-Format die actions ["delete","create"] oder ["create","delete"], dazu einen action_reason und – wenn ein Attribut verantwortlich war – replace_paths.
terraform plan -out=tfplan
terraform show -json tfplan > plan.json
jq -c '.resource_changes[]
  | select(.change.actions | index("delete"))
  | {address, actions: .change.actions, reason: .action_reason, paths: .change.replace_paths}' plan.json
Das listet jedes Löschen und jedes Replacement auf. Bei einem Plan mit drei Replacements kommt je eine Zeile heraus:
{"address":"module.data.aws_db_instance.primary","actions":["delete","create"],"reason":"replace_because_cannot_update","paths":[["storage_encrypted"]]}
{"address":"aws_lb_target_group.web","actions":["create","delete"],"reason":"replace_because_cannot_update","paths":[["port"]]}
{"address":"aws_instance.app","actions":["delete","create"],"reason":"replace_by_triggers","paths":null}
replace_paths fehlt, wenn kein Attribut das Replacement verursacht hat. Ein null dort zusammen mit replace_by_triggers oder replace_because_tainted heißt: Schau dir Lifecycle-Regeln oder den State an, nicht den Diff. HashiCorp bezeichnet diese Gründe als Anzeigehinweise, die sich ändern können – behandle einen unbekannten also als nicht spezifiziert. Den Filter kannst du im jq Playground gegen deinen eigenen Plan ausprobieren.
Wenn du mitten in einem Incident lieber kein jq schreiben willst, füge den Plan in den Terraform Plan Summarizer ein. Für sein vollständiges Beispiel RDS replace (der Plan oben plus ein In-place-Update einer Parameter Group) meldet er plan text · 2 actions · 1 high risk · counts reconcile, und sein Markdown-Report listet:
- `module.data.aws_db_instance.primary` — destroy then create — forces replacement: storage_encryptedSeine ehrliche Grenze: Aus Plan-Text erkennt er Taint-, -replace- und Trigger-Replacements, kann aber nur Attribute benennen, die Terraform mit # forces replacement ausgegeben hat. Für einen versteckten Schuldigen oder den genauen Grund füge stattdessen terraform show -json tfplan ein.
Welche Ursache ist deine?
Sobald du Grund und Pfad kennst, ist die Ursache meist eine von sechs – grob sortiert danach, wie oft sie zuschlagen.
| Was du siehst | Wahrscheinliche Ursache | Erster Schritt |
|---|---|---|
false -> true # forces replacement in einer Zeile, die du bearbeitet hast | Unveränderliches Attribut geändert | Revert oder Migration planen |
-> (known after apply) # forces replacement | Unbekannter Upstream-Wert | Referenz zurückverfolgen |
| Replacement ohne Config-Änderung | Drift oder Normalisierung | terraform plan -refresh-only |
| Plan hat sich mit dem Lock-File geändert | Provider-Upgrade | CHANGELOG des Providers lesen |
Header tainted / as requested | Taint oder -replace | State prüfen |
Header replace_triggered_by | Lifecycle-Trigger | Reichweite des Triggers prüfen |
Der Wert hat sich in deiner Config geändert
1. Du hast ein unveränderliches Attribut bearbeitet. Das Erkennungszeichen ist ein konkreter Wert old -> new mit dem Zusatz. Die Lösung: Revert – oder das Replacement als geplante Migration akzeptieren (bei RDS-Verschlüsselung heißt das: ein Snapshot und ein Restore, die du selbst steuerst). Prüfe mit einem frischen Plan, dass die Ressource ~ update in-place oder gar nichts zeigt.
2. Der Wert ist (known after apply). Das Erkennungszeichen ist <before> -> (known after apply) # forces replacement. In Providern auf Basis des Plugin SDKv2, und dazu gehört der Großteil von hashicorp/aws, wird ein ForceNew-Argument mit unbekanntem neuem Wert als replacement-pflichtig markiert – selbst wenn der endgültige Wert am Ende identisch ist.
Der Upstream ist oft eine andere Ressource, die ersetzt wird, oder ein depends_on, vor dem die depends_on-Doku warnt, weil es mehr Werte unbekannt macht. Behebe es, indem du ein stabiles Attribut referenzierst oder Ausdrucksreferenzen statt depends_on verwendest. Prüfe, dass die Zeile einen konkreten Wert zeigt.
Das Replacement kam von außerhalb des Diffs
3. Drift oder Normalisierung. Das Erkennungszeichen ist ein Replacement, um das niemand gebeten hat, bei dem die API einen Wert in einer anderen Form zurückgegeben hat, als die Config ihn geschrieben hat. Führe terraform plan -refresh-only aus, um zu sehen, was sich außerhalb von Terraform geändert hat, und passe die Config dann an das an, was die API zurückgibt.
4. Ein Provider-Upgrade. Das Erkennungszeichen: Der Plan hat sich an dem Tag geändert, an dem sich das Lock-File geändert hat. Lies den CHANGELOG und den Upgrade-Guide des Providers für den Ressourcentyp, bevor du annimmst, dass deine Config schuld ist.
5. Taint oder -replace. Das Erkennungszeichen ist das Verb im Header und replace_because_tainted bzw. replace_by_request. Wenn das niemand wollte, entferne den Taint:
terraform untaint ADDRESS6. replace_triggered_by. Seit Terraform v1.2 verfügbar, ersetzt es eine Ressource, wenn sich eine referenzierte verwaltete Ressource ändert. Referenzieren lassen sich nur verwaltete Ressourcen, eine einfache Variable läuft deshalb über terraform_data (v1.4+). Prüfe, ob der Trigger breiter greift als beabsichtigt.
Wie verhinderst du ein Replacement, ohne etwas anderes kaputtzumachen?
Wenn das Replacement echt ist, aber die Reihenfolge das Problem ist, macht create_before_destroy aus -/+ ein +/-. Die Doku nennt es opt-in, „because many remote object types have unique name requirements“. Eine Target Group mit festem name zeigt, warum: Namen müssen pro Region und Account eindeutig sein. Solange die alte existiert, lehnt die ELBv2-API das Anlegen deshalb mit DuplicateTargetGroupName ab.
Ersetze name durch name_prefix (bei einer Target Group höchstens 6 Zeichen), damit jedes Replacement einen eindeutigen Suffix bekommt:
resource "aws_lb_target_group" "web" {
  name_prefix = "web-"
  port        = 9090
  protocol    = "HTTP"
  vpc_id      = var.vpc_id

  lifecycle {
    create_before_destroy = true
  }
}
Achtung: Terraform überträgt
create_before_destroyauf die Ressourcen, von denen einecreate_before_destroy-Ressource abhängt. Ein+/-kann also an einer Ressource auftauchen, deren eigener Block es nie gesetzt hat.
Stammt das Replacement aus einem Refactoring, etwa dem Wechsel von count zu for_each, hat sich am Remote-Objekt nichts geändert. Nutze einen moved-Block (Terraform v1.1+), dann zeigt der Plan has moved to statt Löschen und Anlegen:
moved {
  from = aws_instance.c[0]
  to   = aws_instance.c["small"]
}
Für alles, was Daten hält, brauchst du eine Absicherung. prevent_destroy lehnt jeden Plan ab, der das Objekt zerstören würde, auch ein erzwungenes Replacement (Datei- und Zeilenkontext gekürzt):
Error: Instance cannot be destroyed

Resource module.data.aws_db_instance.primary has lifecycle.prevent_destroy set, but the plan calls for this resource to be destroyed. To avoid this error and continue with the plan, either disable lifecycle.prevent_destroy or reduce the scope of the plan using the -target option.
Wichtig:
prevent_destroyverhindert kein Löschen, wenn jemand den Ressourcenblock selbst entfernt. Außerdem blockiert esterraform destroy, und Lifecycle-Argumente akzeptieren nur Literalwerte.
Ist ignore_changes die Lösung, die keine ist?
ignore_changes ist die häufigste Antwort in Foren, und es lässt das -/+ tatsächlich verschwinden. Laut Lifecycle-Doku werden ignorierte Argumente beim Planen eines Create berücksichtigt, beim Planen eines Update aber ignoriert.
Genau das ist das Problem. Ein ignoriertes ForceNew-Attribut unterdrückt das Replacement – und jeden künftigen Diff darauf. Ändert später jemand dieses Attribut außerhalb von Terraform, erwähnt der Plan es nie wieder. Deine Config sagt dann das eine, das echte Objekt das andere, und nichts meldet die Lücke. Mit ignore_changes = all deckt dieses Schweigen die ganze Ressource ab.
Setz es für Attribute ein, die rechtmäßig einem anderen System gehören, etwa ein Tag, das ein Scheduler schreibt. Setz es nicht ein, um einen beunruhigenden Plan zum Schweigen zu bringen. Wenn das Attribut dir gehört, sind die ehrlichen Optionen: die Änderung zurücknehmen oder bewusst ersetzen.
Wie lässt du CI scheitern, wenn ein Plan eine Datenbank ersetzt?
Ein menschliches Review übersieht ein -/+ in einem langen Plan. Eine Pipeline nicht. Dieser Filter endet mit einem Exit-Code ungleich null, sobald der Plan einen Datenspeicher löscht, egal ob durch Destroy oder Replacement:
terraform show -json tfplan > plan.json
jq -e '[.resource_changes[]
  | select((.change.actions | index("delete"))
      and (.type | test("^aws_(db_instance|rds_cluster|dynamodb_table|s3_bucket|efs_file_system)$")))]
  | length == 0' plan.json
Beim Plan oben gibt er false aus und endet mit Exit-Code 1. Bei einem sauberen Plan gibt er true aus und endet mit 0. Lass ihn als Pflichtschritt vor apply laufen, und mach das Übergehen zu einer bewussten, reviewten Aktion.
Tipp: Halte die Typliste neben der Pipeline und ergänze sie um alles, was in deinem Account State hält. Der Guide AWS for DevOps engineers behandelt RDS-Backups und manuelle Snapshots – deine Sicherheitskopie vor jedem geplanten Replacement.
Dasselbe Gate passt in jeden Runner. Läuft deine Pipeline in GitHub Actions, kombiniere es mit den Prüfungen aus GitHub-Actions-Sicherheitsfehlkonfigurationen. Auf GitLab sorgt das Validieren der .gitlab-ci.yml dafür, dass der Job, der es ausführt, nicht still kaputtgeht.
Was solltest du prüfen, bevor du einen -/+-Plan freigibst?
- Lies das Verb im Header, nicht nur das Symbol:
must be replaced,is tainted,as requestedundreplace_triggered_bydeuten auf verschiedene Ursachen. - Führe
terraform show -json tfplanaus und liste jede Ressource, derenactionseindeleteenthalten, mitaction_reasonundreplace_paths. - Bestätige für jeden Eintrag in
replace_paths, dass das Attribut für diesen Ressourcentyp wirklich unveränderlich ist. - Verfolge bei
(known after apply)die Referenz bis zu der Ressource zurück, die den Wert unbekannt macht. - Führe bei einem Replacement ohne Config-Änderung
terraform plan -refresh-onlyaus und prüfe den Changelog des Providers. - Füge bei einem Refactoring einen
moved-Block hinzu und plane neu, bis das Löschen verschwindet. - Stelle bei
create_before_destroysicher, dass die Namen nebeneinander existieren können, oder wechsle zuname_prefix. - Stelle sicher, dass jeder Datenspeicher
prevent_destroyträgt und CI das jq-Gate ausführt.
Wenn ein Plan das nächste Mal -/+ sagt, füge ihn in den Terraform Plan Summarizer ein, bevor irgendwer auf Approve klickt.
Welches Replacement ist bei dir am weitesten durchs Review gekommen, bevor jemand das -/+ bemerkt hat?
Ähnliche Beiträge
-

7 Min. Lesezeit
chown-Befehl in Linux: Besitzer und Gruppe von Dateien ändern
Der chown-Befehl in Linux erklärt: user:group-Syntax, chown -R und Symlinks, --reference, chgrp, chmod vs chown und Berechtigungsfehler bei Docker-Volumes mit numerischen IDs beheben.
-

10 Min. Lesezeit
chmod-Befehl in Linux: Syntax, Beispiele und typische Fehler
Der chmod-Befehl in Linux erklärt: oktale und symbolische Modi, chmod +x, chmod -R und seine Fallen, setuid, setgid und Sticky-Bit, umask und wie du Permission denied behebst.
-
7 Min. Lesezeit
CIDR-Notation lesen, mit Beispielen aus der Praxis
CIDR-Notation lesen: was die Zahl nach dem Schrägstrich bedeutet, eine Tabelle Präfix zu Netzmaske von /8 bis /32 und Beispiele aus VPCs, Firewalls und Kubernetes.