Langue: Français
IR-09 · iac
Pushkar Kumar 12 min de lecture
Terraform forces replacement : comprendre -/+ et corriger
Terraform force un remplacement quand un attribut ne peut changer sur place : ce que signifie -/+, trouver la cause avec show -json et jq, et l'empêcher.
- terraform
- ci-cd
- devops
Sur cette page
- Que signifie « terraform forces replacement » ?
- Pourquoi certains remplacements n’ont-ils pas de ligne « # forces replacement » ?
- Comment trouver l’attribut qui a forcé le remplacement ?
- Laquelle de ces causes est la vôtre ?
- La valeur a changé dans votre configuration
- Le remplacement vient de l’extérieur du diff
- Comment empêcher un remplacement sans casser autre chose ?
- ignore_changes, le correctif qui n’en est pas un ?
- Comment faire échouer la CI quand un plan remplace une base de données ?
- Que vérifier avant d’approuver un plan -/+ ?
Vous n’avez demandé qu’une petite modification : activer le chiffrement d’une base de données. La pull request fait trois lignes. Puis le plan revient, et l’une des ressources qu’il contient (abrégée ici) devrait vous arrêter net :
  # module.data.aws_db_instance.primary must be replaced
-/+ resource "aws_db_instance" "primary" {
      ~ storage_encrypted                     = false -> true # forces replacement
        # (35 unchanged attributes hidden)
    }

Plan: 1 to add, 1 to change, 1 to destroy.
Quand Terraform force un remplacement, ce « 1 to destroy », c’est votre base de données de production. Le plan ne se trompe pas. Il vous dit que la modification ne peut pas se faire sur place, et que l’approuver supprime d’abord l’objet existant.
TL;DR
-/+signifie détruire, puis créer.+/-signifie créer, puis détruire, et n’apparaît que lorsquecreate_before_destroyest actif.# forces replacementdésigne l’attribut responsable, mais les remplacements issus de-replace, d’un taint ou dereplace_triggered_byne l’affichent jamais.- La vérification qui n’en rate aucun :
terraform show -json tfplan | jqsur.change.actions,.action_reasonet.change.replace_paths.- Corrigez la cause (annuler la modification,
moved,name_prefix), protégez les stockages de données avecprevent_destroy, et faites échouer la CI sur tout plan qui en supprime un.
Que signifie « terraform forces replacement » ?
Chaque ressource gérée possède des arguments que le provider peut modifier via une API de mise à jour, et d’autres qu’il ne peut pas modifier. Dans le provider AWS, storage_encrypted sur aws_db_instance appartient à la seconde catégorie : le schéma le marque ForceNew. C’est aussi le cas de kms_key_id, availability_zone, db_name et username. engine_version, en revanche, ne l’est pas, ce qui explique qu’une montée de version se fasse sur place.
Dès qu’un de ces attributs change, Terraform planifie un remplacement. La légende du plan détaille les deux ordres possibles :
-/+ destroy and then create replacement
+/- create replacement and then destroy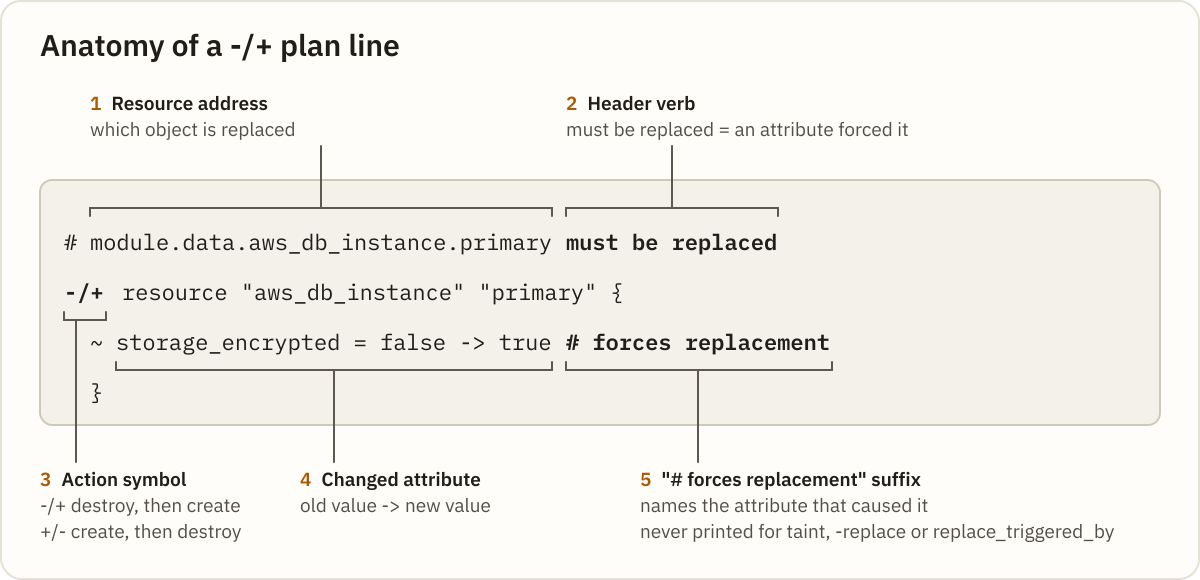
Détruire puis créer, c’est le comportement par défaut. Terraform ne passe à +/- que lorsque create_before_destroy s’applique à la ressource. La ligne d’en-tête au-dessus de la ressource compte autant que le symbole. must be replaced signifie qu’un attribut a imposé le remplacement. Les autres verbes signifient que c’est autre chose, et c’est la question suivante.
Pourquoi certains remplacements n’ont-ils pas de ligne « # forces replacement » ?
Chercher forces replacement dans le plan avec grep donne l’impression d’une vérification complète. Ce n’en est pas une. Terraform n’affiche ce suffixe que sur les attributs que le provider a signalés comme exigeant un remplacement. Trois types de remplacement n’ont aucun attribut de ce genre, et le verbe de l’en-tête est alors le seul indice :
  # aws_instance.app is tainted, so must be replaced
  # aws_instance.app will be replaced, as requested
  # aws_instance.app will be replaced due to changes in replace_triggered_by
Le premier vient de terraform taint (désormais déprécié au profit de -replace), le deuxième de terraform apply -replace=ADDRESS, le troisième d’une règle de cycle de vie replace_triggered_by.
Il existe un quatrième piège. Si un provider signale comme exigeant un remplacement un attribut qui n’a pas changé, Terraform peut le ranger dans (N unchanged attributes hidden). Le cas a été signalé dans hashicorp/terraform#36097 et clos comme conforme au fonctionnement prévu. Le plan indique must be replaced sans montrer le moindre coupable.
Comment trouver l’attribut qui a forcé le remplacement ?
Arrêtez de lire le plan destiné aux humains et lisez celui destiné aux machines. Dans le format JSON du plan, chaque remplacement porte des actions valant ["delete","create"] ou ["create","delete"], ainsi qu’un action_reason et, lorsqu’un attribut en est responsable, des replace_paths.
terraform plan -out=tfplan
terraform show -json tfplan > plan.json
jq -c '.resource_changes[]
  | select(.change.actions | index("delete"))
  | {address, actions: .change.actions, reason: .action_reason, paths: .change.replace_paths}' plan.json
La commande liste chaque destruction ou remplacement. Sur un plan comportant trois remplacements, elle affiche une ligne pour chacun :
{"address":"module.data.aws_db_instance.primary","actions":["delete","create"],"reason":"replace_because_cannot_update","paths":[["storage_encrypted"]]}
{"address":"aws_lb_target_group.web","actions":["create","delete"],"reason":"replace_because_cannot_update","paths":[["port"]]}
{"address":"aws_instance.app","actions":["delete","create"],"reason":"replace_by_triggers","paths":null}
replace_paths est omis lorsqu’aucun attribut n’a causé le remplacement. Un null à cet endroit, accompagné de replace_by_triggers ou replace_because_tainted, signifie qu’il faut regarder les règles de cycle de vie ou le state, pas le diff. HashiCorp présente ces raisons comme des indications d’affichage susceptibles d’évoluer : considérez donc une raison inconnue comme non spécifiée. Vous pouvez essayer le filtre sur votre propre plan dans le jq playground.
Si vous préférez ne pas écrire de jq en plein incident, collez le plan dans le Terraform Plan Summarizer. Sur son exemple complet RDS replace (le plan ci-dessus, plus une mise à jour sur place d’un parameter group), il affiche plan text · 2 actions · 1 high risk · counts reconcile, et son rapport Markdown indique :
- `module.data.aws_db_instance.primary` — destroy then create — forces replacement: storage_encryptedSa limite, en toute honnêteté : à partir du texte du plan, il signale les remplacements dus à un taint, à -replace ou à un trigger, mais ne peut nommer que les attributs que Terraform a affichés avec # forces replacement. Pour un coupable masqué ou la raison exacte, collez plutôt la sortie de terraform show -json tfplan.
Laquelle de ces causes est la vôtre ?
Une fois la raison et le chemin connus, la cause est généralement l’une des six suivantes, classées à peu près selon leur fréquence.
| Ce que vous voyez | Cause probable | Premier réflexe |
|---|---|---|
false -> true # forces replacement sur une ligne que vous avez modifiée | Attribut immuable modifié | Revenir en arrière, ou planifier une migration |
-> (known after apply) # forces replacement | Valeur amont inconnue | Remonter la référence |
| Remplacement sans modification de la configuration | Dérive ou normalisation | terraform plan -refresh-only |
| Le plan a changé en même temps que le fichier de verrouillage | Mise à jour du provider | Lire le CHANGELOG du provider |
En-tête tainted / as requested | Taint ou -replace | Vérifier le state |
En-tête replace_triggered_by | Trigger de cycle de vie | Vérifier la portée du trigger |
La valeur a changé dans votre configuration
1. Vous avez modifié un attribut immuable. L’indice, c’est une valeur concrète old -> new accompagnée du suffixe. Le correctif consiste à revenir en arrière, ou à accepter le remplacement comme une migration planifiée (pour le chiffrement RDS, cela signifie un snapshot puis une restauration que vous maîtrisez). Vérifiez avec un nouveau plan que la ressource affiche ~ update in-place, ou rien du tout.
2. La valeur est (known after apply). L’indice, c’est <before> -> (known after apply) # forces replacement. Dans les providers construits sur le plugin SDKv2, ce qui couvre l’essentiel de hashicorp/aws, un argument ForceNew dont la nouvelle valeur est inconnue est marqué comme exigeant un remplacement, même si la valeur finale s’avère identique.
L’amont est souvent une autre ressource en cours de remplacement, ou un depends_on dont la documentation de depends_on prévient qu’il rend davantage de valeurs inconnues. Corrigez en référençant un attribut stable, ou en utilisant des références d’expression plutôt que depends_on. Vérifiez que la ligne affiche une valeur concrète.
Le remplacement vient de l’extérieur du diff
3. Dérive ou normalisation. L’indice, c’est un remplacement que personne n’a demandé, où l’API a renvoyé une valeur sous une forme différente de celle écrite dans la configuration. Lancez terraform plan -refresh-only pour voir ce qui a changé en dehors de Terraform, puis alignez la configuration sur ce que renvoie l’API.
4. Une mise à jour du provider. L’indice, c’est que le plan a changé le jour où le fichier de verrouillage a changé. Lisez le CHANGELOG et le guide de mise à jour du provider pour le type de ressource avant de supposer que votre configuration est en cause.
5. Taint ou -replace. L’indice, c’est le verbe de l’en-tête et replace_because_tainted ou replace_by_request. Si personne ne l’a voulu, retirez le taint :
terraform untaint ADDRESS6. replace_triggered_by. Disponible depuis Terraform v1.2, il remplace une ressource lorsqu’une ressource gérée référencée change. Seules les ressources gérées peuvent être référencées : une simple variable doit donc passer par terraform_data (v1.4+). Vérifiez si le trigger est plus large que prévu.
Comment empêcher un remplacement sans casser autre chose ?
Quand le remplacement est bien réel mais que c’est l’ordre qui pose problème, create_before_destroy transforme -/+ en +/-. La documentation explique que ce comportement est optionnel « parce que de nombreux types d’objets distants imposent des noms uniques ». Un target group avec un name fixe montre pourquoi : les noms doivent être uniques par région et par compte, donc tant que l’ancien existe, l’API ELBv2 rejette la création avec DuplicateTargetGroupName.
Remplacez name par name_prefix (6 caractères au maximum pour un target group) afin que chaque remplacement reçoive un suffixe unique :
resource "aws_lb_target_group" "web" {
  name_prefix = "web-"
  port        = 9090
  protocol    = "HTTP"
  vpc_id      = var.vpc_id

  lifecycle {
    create_before_destroy = true
  }
}
Attention : Terraform propage
create_before_destroyaux ressources dont dépend une ressource encreate_before_destroy, si bien qu’un+/-peut apparaître sur une ressource dont le bloc ne l’a jamais activé.
Si le remplacement vient d’un refactoring, par exemple le passage de count à for_each, rien n’a changé dans l’objet distant. Utilisez un bloc moved (Terraform v1.1+) et le plan affichera has moved to au lieu d’une destruction suivie d’une création :
moved {
  from = aws_instance.c[0]
  to   = aws_instance.c["small"]
}
Pour tout ce qui contient des données, ajoutez un garde-fou. prevent_destroy rejette tout plan qui détruirait l’objet, y compris un remplacement forcé (contexte de fichier et de ligne abrégé) :
Error: Instance cannot be destroyed

Resource module.data.aws_db_instance.primary has lifecycle.prevent_destroy set, but the plan calls for this resource to be destroyed. To avoid this error and continue with the plan, either disable lifecycle.prevent_destroy or reduce the scope of the plan using the -target option.
Important :
prevent_destroyn’empêche pas une destruction si quelqu’un supprime le bloc de la ressource lui-même. Il bloque aussiterraform destroy, et les arguments de cycle de vie n’acceptent que des valeurs littérales.
ignore_changes, le correctif qui n’en est pas un ?
ignore_changes est la réponse la plus fréquente sur les forums, et il fait bel et bien disparaître le -/+. La documentation du cycle de vie précise que les arguments ignorés sont pris en compte lors de la planification d’une création, mais ignorés lors de la planification d’une mise à jour.
C’est justement là le problème. Ignorer un attribut ForceNew supprime le remplacement, mais aussi tout diff futur sur cet attribut. Si quelqu’un le modifie plus tard en dehors de Terraform, le plan n’en parlera plus jamais. Votre configuration dit une chose, l’objet réel en dit une autre, et rien ne signale l’écart. Avec ignore_changes = all, ce silence couvre la ressource entière.
Réservez-le aux attributs qu’un autre système possède légitimement, comme un tag écrit par un planificateur. Ne vous en servez pas pour faire taire un plan inquiétant. Si l’attribut vous appartient, les options honnêtes sont d’annuler la modification ou de remplacer en connaissance de cause.
Comment faire échouer la CI quand un plan remplace une base de données ?
Une relecture humaine laisse passer un -/+ dans un long plan. Un pipeline, non. Ce filtre sort avec un code non nul dès que le plan supprime un stockage de données, que ce soit par destruction ou par remplacement :
terraform show -json tfplan > plan.json
jq -e '[.resource_changes[]
  | select((.change.actions | index("delete"))
      and (.type | test("^aws_(db_instance|rds_cluster|dynamodb_table|s3_bucket|efs_file_system)$")))]
  | length == 0' plan.json
Sur le plan ci-dessus, il affiche false et sort avec le code 1. Sur un plan sain, il affiche true et sort avec le code 0. Exécutez-le comme étape obligatoire avant apply, et faites de son contournement une action délibérée et relue.
Astuce : Gardez la liste des types à côté du pipeline et complétez-la avec tout ce qui conserve un état dans votre compte. Le guide AWS pour les ingénieurs DevOps couvre les sauvegardes RDS et les snapshots manuels, votre copie de sécurité avant tout remplacement planifié.
Ce même garde-fou s’intègre à n’importe quel runner. Si votre pipeline tourne sur GitHub Actions, associez-le aux vérifications de mauvaises configurations de sécurité de GitHub Actions. Sur GitLab, valider votre .gitlab-ci.yml évite que le job qui l’exécute ne casse en silence.
Que vérifier avant d’approuver un plan -/+ ?
- Lisez le verbe de l’en-tête, pas seulement le symbole :
must be replaced,is tainted,as requestedetreplace_triggered_byrenvoient à des causes différentes. - Lancez
terraform show -json tfplanet listez chaque ressource dont lesactionscontiennentdelete, avecaction_reasonetreplace_paths. - Pour chaque
replace_paths, confirmez que l’attribut est réellement immuable pour ce type de ressource. - Pour un
(known after apply), remontez la référence jusqu’à la ressource qui la rend inconnue. - Pour un remplacement sans modification de la configuration, lancez
terraform plan -refresh-onlyet consultez le changelog du provider. - Pour un refactoring, ajoutez un bloc
movedet relancez le plan jusqu’à ce que la destruction disparaisse. - Pour
create_before_destroy, vérifiez que les noms peuvent coexister, ou passez àname_prefix. - Vérifiez que chaque stockage de données porte
prevent_destroyet que la CI exécute le garde-fou jq.
La prochaine fois qu’un plan affiche -/+, collez-le dans le Terraform Plan Summarizer avant que quiconque clique sur approve.
Quel est le remplacement qui est allé le plus loin dans votre relecture avant que quelqu’un remarque le -/+ ?
Articles liés
-

8 min de lecture
Commande chown sous Linux : changer le propriétaire et le groupe
La commande chown sous Linux expliquée : syntaxe user:group, chown -R et liens symboliques, --reference, chgrp, chmod vs chown, et corriger les permissions des volumes Docker avec des ID numériques.
-

11 min de lecture
Commande chmod sous Linux : syntaxe, exemples et erreurs courantes
La commande chmod sous Linux expliquée : modes octal et symbolique, chmod +x, chmod -R et ses pièges, setuid, setgid et sticky bit, umask, et comment corriger Permission denied.
-
9 min de lecture
Comment lire la notation CIDR, avec des exemples concrets
Lire la notation CIDR : le sens du nombre après la barre oblique, une table préfixe → masque de /8 à /32, et des exemples réels de VPC, pare-feu et Kubernetes.